Innovation de l’intelligence artificielle appliquée à l’analyse d’images médicales en sénologie et cardiologie interventionnelle


Xavier Lessage est chercheur au sein du département Sciences des données au CETIC. Ses centres d’intérêts sont les intelligences artificielles, le Cloud Computing ainsi que le traitement de données distribuées (High Performance Computing).  L’un de ses domaines de prédilection est la santé et plus particulièrement, l’usage de l’intelligence artificielle dans les soins de santé.

Les axes majeurs de ses travaux concernent le cancer du sein et la cardiologie interventionnelle à l’aide d’architectures traditionnelles et fédérées. Ses recherches consistent d’une part, à évaluer les algorithmes de Deep learning (classification binaire, localisation d’anomalie, explicabilité, etc.) dans le domaine de l’imagerie médicale avec des bases de données privées (étude rétrospective). D’autre part, à valider les modèles retenus dans les hôpitaux mais avec de nouvelles images (étude prospective) avec pour objectif d’analyser le comportement de l’IA en situation réelle.

En contribuant à la réduction du coût et de la charge de travail des médecins grâce à la combinaison des deux intelligences : la première, artificielle pour faire une première analyse et la seconde, humaine, pour interpréter les résultats et poser le bon diagnostic. Dans le cadre du cancer du sein notamment, l’interprétation d’une image mammographique est une tâche difficile à réaliser et nécessite, une vérification par un second lecteur, voire un troisième (en cas de divergence) afin de réduire le nombre de faux négatif. Le rôle de la seconde lecture pourrait-être pris en charge par une IA laissant ainsi du temps pour le second lecteur pour d’autres tâches, comme celle de premier lecteur.

Pour en savoir plus sur ses projets en cours ou ses publications : https://cutt.ly/gOigulY

Vers une intelligence artificielle qui intègre la notion d’équité

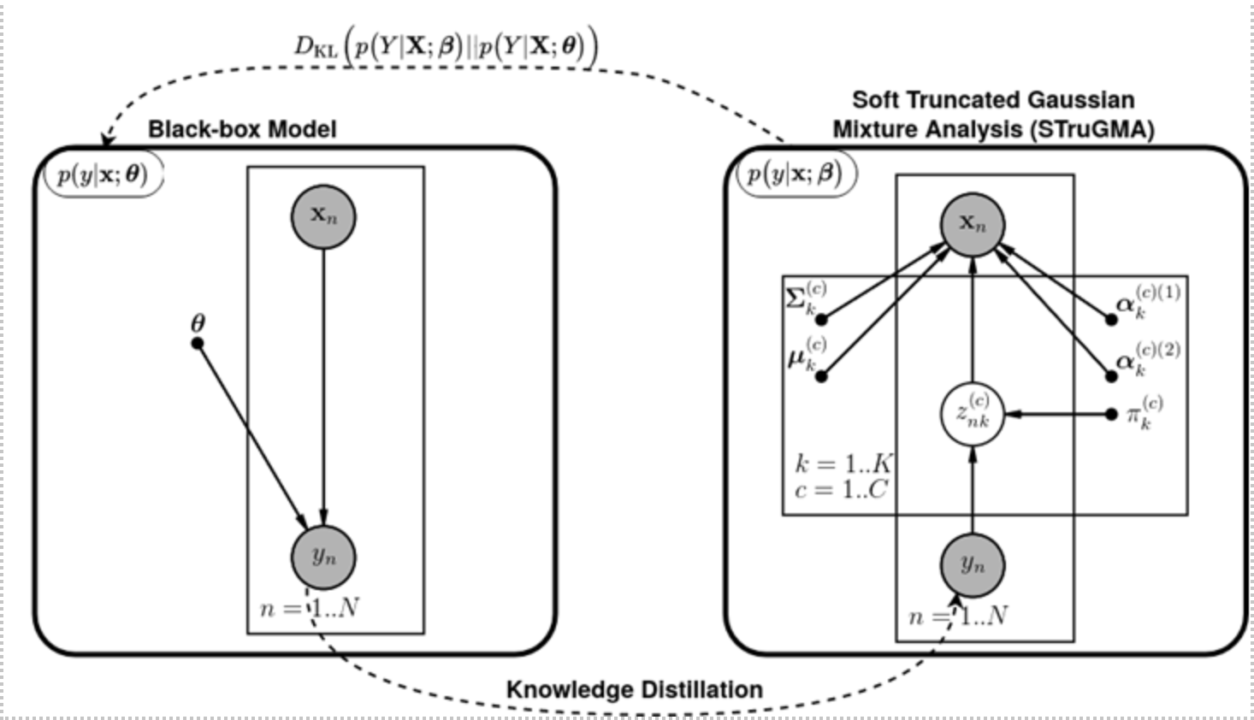
Géraldin Nanfack, chercheur à l’UNamur, travaille depuis décembre 2018 sur sa thèse dans le cadre du projet EOS VeriLearn. Ses travaux de recherche ont pour but de garantir le respect des propriétés ou de certaines contraintes à des algorithmes de Machine Learning. Par exemple, dans l’un de ses travaux [1] publiés à la conférence ESANN’21, il a proposé une méthode pour forcer des algorithmes d’arbres de décision à prendre des décisions équitables par rapport à descaractéristiques sensibles comme la race ou le genre. Dans un autre travail [2] publié à la conférence UAI’21, il a développé une méthode visant à contraindre des modèles dits “black-box” et différentiables comme des réseaux de neurones, à s’expliquer facilement et globalement par des règles de décisions afin que les utilisateurs non- experts de cette intelligence artificielle puissent comprendre comment les décisions ont été prises.

Ses travaux visent à avoir une Intelligence Artificielle (IA) plus fiable, qui pourra être dotée de facultés pour fournir des explications fidèles de son comportement. Cette évolution de l’IA est précieuse pour plusieurs secteurs sensibles comme celui de la santé ou bancaire qui pourrait utiliser une IA prédisposée à fournir des explications fiables de ses décisions tout en garantissant ou maximisant l’équité dans ses prédictions.

[1] Nanfack, G., Delchevalerie, V., & Frénay, B. (2021). Boundary-Based Fairness Constraints in Decision Trees and Random Forests. In The 29th European Symposium on Artificial Neural Networks, Computational Intelligence and Machine Learning, https://proceedings.mlr.press/v161/nanfack21a.html.

[2] Nanfack, G., Temple, P., & Frénay, B. (2021, December). Global explanations with decision rules: a co-learning approach. In Uncertainty in Artificial Intelligence (pp. 589-599). PMLR, https://pure.unamur.be/ws/portalfiles/portal/61249591/ES2021_69.pdf.


Une intelligence artificielle apprend avec moi à trouver les causes de maladies génétiques dans les publications scientifiques

Passionnée par le secret derrière les maladies génétiques, Charlotte Nachtegael s’est engagée, après avoir obtenu son diplôme en master en sciences biomédicales à l’UMONS, dans un master et puis un doctorat en Bioinformatique sur l’étude des maladies génétiques complexes à l’(IB)2 (Interuniversity Institute in Bioinformatics in Brussels) et au MLG (Machine Learning Group) à l’ULB.

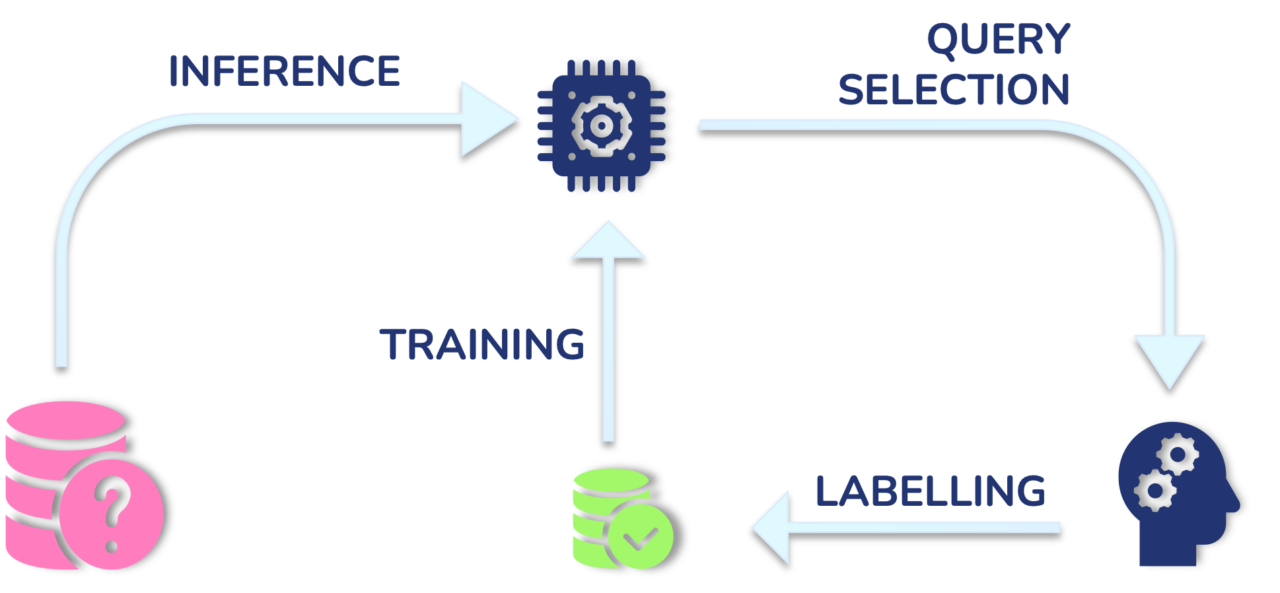
Son travail a premièrement consisté à trouver dans la littérature scientifique des combinaisons de mutations causant des maladies génétiques complexes, récoltées sous forme d’une base de données (publication en cours de révision). Ce travail colossal de biocuration l’a encouragée à se concentrer sur les techniques de text mining pour être capable d’extraire automatiquement ces données du texte des articles et les rendre facilement disponibles. Elle utilise également le principe de l’active learning, impliquant directement l’expert humain dans l’apprentissage du modèle d’intelligence artificielle.

Cette extraction automatique des données sur les maladies génétiques complexes serait un avantage pour le monde médical et bioinformatique, d’autant plus vu l’augmentation des données génétiques et du nombre de publications sur le sujet. Ces données pourront être utilisées pour étudier les causes des maladies génétiques rares ou pour développer des modèles de prédictions lors d’une grossesse… De plus, on ouvre également la porte à une interaction directe entre l’intelligence artificielle et l’humain grâce à l’active learning, où c’est l’humain qui enseigne directement à un modèle. Ce travail devrait donc, on l’espère, accroître la confiance envers l’intelligence artificielle.

RemedIA

Enjeu

Intégrer l’ensemble des données et informations sur les patients par l’Intelligence Artificielle pour développer les meilleurs trajets de soins, et par là en réduire de façon significative les coûts tout en augmentant la qualité et l’accessibilité pour les patients.  Voici le pari ambitieux du projet ReMedIA (Réseau ouvert d’Expertise en Médecine des systèmes par l’IA).

Brève description

Le but de ReMedIA est d’exploiter les nombreuses données biologiques (ADN, ARN, protéines, métabolites, …), cliniques (imagerie, évaluations fonctionnelles, …), environnementales et psycho-sociales qui seront disponibles afin de construire des modèles prédictifs à partir de l’Intelligence Artificielle et de les appliquer à la mise au point de meilleurs dépistages, de meilleurs diagnostics, de meilleurs plans de traitement. Ceci en veillant également à permettre une implication plus effective du patient dans les choix thérapeutiques grâce à l’explicitation des modèles.

Afin de déployer efficacement cette approche, l’initiative ReMedIA sera constituée en association de fait au travers d’un pacte d’entente reliant l’ensemble des acteurs clés du domaine en Région Wallonne, en s’appuyant sur les outils déjà existants (Biowin, Patient Numérique, Hospitals.be, …). Un portefeuille de 8 projets permettra de couvrir l’ensemble du domaine. ReMedIA constituera ainsi un Hub d’innovation permettant la traduction des meilleurs résultats des recherches dans la pratique clinique et d’organiser efficacement les données collectées dans les hôpitaux mais aussi au travers de cohortes en Wallonie et intégrer ces cohortes dans les grandes initiatives internationales.

Partenaires déjà identifiés

IdentificationAcronymeType de partenaire
Chef de file :  
 UCLouvainUniversité
Partenaires :  
 ULBUniversité
 ULiègeUniversité
 UMonsUniversité
 UNamurUniversité
 MultitelCentre de recherche agréé
 CeticCentre de recherche agréé
 Cliniques de Mont GodinneHôpital universitaire
 CHU Sart TilmanHôpital Universitaire
 Clinique d’OttigniesASBL (Hôpital)
 Grand Hôpital de Charleroi (GHdC)ASBL (Hôpital)
 Clinique Le Beau VallonHôpital Psychiatrique
 CurePathASBL
 Pôle Hospitalier de JolimontASBL
 Biowin, Pôle de compétitivité en Région wallonne , biotech et tech médicalesASBL

Statut du projet

Déposé dans le cadre d’une IIS (Initiative d’Innovation Stratégique) en novembre 2021, ouvert à collaborer sur des initiatives similaires au niveau européen.

Quand l’intelligence artificielle et la compression d’images se rencontrent, la surveillance vidéo devient respectueuse de la vie privée

Depuis septembre 2020, lors de la première édition de l’atelier TRAIL, Karim El Khoury et Jonathan Samelson, ont débuté leurs travaux dont le but était de fournir une représentation d’image publique et respectueuse de la vie privée, pour l’analyse du trafic autoroutier. L’objectif était d’utiliser les images résiduelles du domaine compressé, peu coûteuses et respectueuses de la vie privée, pour suivre efficacement les véhicules. En novembre 2021, leurs travaux ont été publiés dans le Frontiers in Signal Processing Journal dans le cadre d’un numéro spécial sur l’apprentissage profond pour la vidéosurveillance. La publication est accessible via https://doi.org/10.3389/frsip.2021.765006

Selon Karim et Jonathan, le principal problème du big data, et plus particulièrement des données de vidéosurveillance, est la confidentialité. C’est donc pourquoi, en proposant l’utilisation de cadres résiduels de domaine compressé comme représentation d’image pour le suivi d’objets basé sur l’apprentissage profond, leur solution d’IA donne la priorité au droit à la vie privée des personnes tout en maintenant des performances efficaces.


Résultats expérimentaux de la détection et le suivi des véhicules sur les images résiduelles du domaine compressé respectueuses de la vie privée (A) contre les images décodées intrusives (B)